


الگوریتم جنگل تصادفی (Random Forest) چیست؟ بررسی نحوه عملکرد، مزایا و کاربرد در ارز دیجیتال
الگوریتم جنگل تصادفی (Random Forest) یکی از قدرتمندترین ابزارهای یادگیری ماشین است که با ترکیب چندین مدل تصمیمگیری، خرد جمعی را برای رسیدن به پیشبینیهای دقیق به کار میگیرد. اما این سادگی ساختاری، پاشنه آشیل بسیاری از تحلیلگران تازهکار است؛ چرا که پشت این مفهوم آشنا، پیچیدگیهایی در مدیریت دادههای تصادفی پنهان شده که مدلهای ناپخته را به راحتی از کار میاندازد.

تصور کنید ساعتها وقت صرف ساختن یک مدل تحلیلی کردهاید و همهچیز روی دادههای تمرینی بینقص کار میکند، اما به محض ورود اطلاعات جدید در دنیای واقعی، پیشبینیها کاملا اشتباه از آب در میآیند. این همان نقطهای است که اتکای کورکورانه به یک الگوریتم بدون درک منطق درونی آن، تمام معادلات و زحمات شما را به هم میریزد. در این مقاله، ساختار الگوریتم جنگل تصادفی را بررسی میکنیم و به شما نشان میدهیم چطور با تسلط بر نحوه عملکرد و تنظیمات دقیق آن، مدلهایی بسازید که در مواجهه با دادههای پیشبینینشده، همچنان دقیق و قابل اتکا باقی بمانند.
الگوریتم جنگل تصادفی یا Random Forest چیست؟
وقتی صحبت از تحلیل دادهها و پیشبینی آینده میشود، هوش مصنوعی ابزارهای قدرتمندی را در اختیار ما قرار میدهد. یکی از محبوبترین و دقیقترین ابزارها در این مسیر، الگوریتم جنگل تصادفی است. این روش با الگوبرداری از خرد جمعی، به سیستمهای کامپیوتری کمک میکند تا تصمیمات منطقیتر و کمخطاتری بگیرند.
تعریف ساده الگوریتم جنگل تصادفی برای افراد مبتدی
الگوریتم جنگل تصادفی یکی از روشهای بسیار پرکاربرد در حوزهی یادگیری ماشین (Machine Learning: روشی که به کامپیوترها آموزش میدهد از دادههای گذشته الگو بگیرند و بر اساس آنها تصمیمگیری کنند) است.
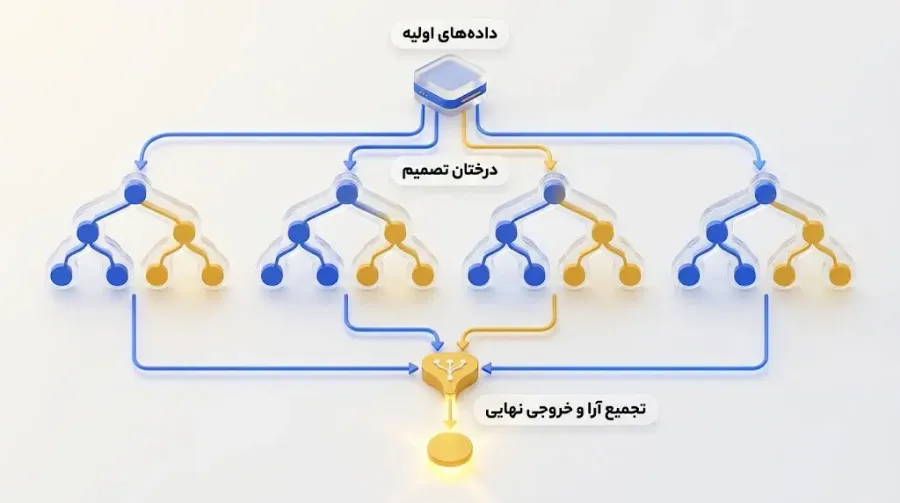
همانطور که از نام این مدل پیداست، جنگل تصادفی از کنار هم قرار گرفتن تعداد زیادی درخت ایجاد میشود. در دنیای دادهها، به هر کدام از این شاخهها یک درخت تصمیم میگویند. درخت تصمیم به تنهایی مانند فردی است که بر اساس یک سری سوالات سادهی بله و خیر، مسیر را طی میکند تا به یک نتیجه برسد. اما در مدل جنگل تصادفی، ما به جای تکیه بر تصمیم تنها یک درخت، دهها یا صدها درخت تصمیم را در کنار هم قرار میدهیم تا هر کدام به صورت کاملا مستقل، دادهها را بررسی کنند.
در نهایت، الگوریتم با جمعآوری نظرات تمام این درختها و گرفتن میانگین یا رایگیری، تصمیم نهایی را اعلام میکند. این روش معمولا برای دو کار اصلی یعنی کلاسبندی (Classification: دستهبندی دادهها به گروههای مشخص، مانند تشخیص یک تراکنش سالم از یک تراکنش مخرب) و رگرسیون (Regression: پیشبینی یک مقدار عددی پیوسته مانند قیمت احتمالی فردا) استفاده میشود.
درک مفهوم جنگل تصادفی با یک مثال جذاب از دنیای واقعی
تصور کنید میخواهید روی یک پروژهی جدید در دنیای رمزارز سرمایهگذاری کنید، اما کاملا مطمئن نیستید که این تصمیم درستی است یا خیر. اگر برای این کار فقط با یک نفر از دوستان خود مشورت کنید، ممکن است آن شخص بر اساس تعصبات شخصی یا اطلاعات محدود خود، شما را گمراه کند. این رفتار دقیقا مشابه عملکرد یک درخت تصمیم است که اگر دادههای اشتباهی به آن برسد، خروجی اشتباهی تولید میکند.
حالا رویکرد خود را تغییر دهید و ایدهی جنگل تصادفی را اجرا کنید! شما تصمیم میگیرید با ۱۰۰ نفر از تحلیلگران مختلف مشورت کنید. به برخی از آنها اطلاعات مربوط به تیم توسعهدهندهی پروژه را میدهید، به دستهی دیگر میگویید فقط حجم معاملات و نمودارهای قیمت را بررسی کنند و گروهی دیگر را مسئول پیگیری اخبار بازار میکنید.
حالا هر تحلیلگر نظر مستقل خود را مبنی بر خرید یا عدم خرید به شما اعلام میکند. در مرحلهی آخر، شما بررسی میکنید که اکثریت این ۱۰۰ نفر چه نظری داشتهاند. اگر ۸۰ نفر موافق خرید باشند، شما با اطمینان بسیار بالاتری سرمایهگذاری میکنید. در اینجا، آن ۱۰۰ تحلیلگر همان درختان جنگل شما هستند که با بررسی بخشهای تصادفی و متفاوتی از اطلاعات، شما را به یک تصمیم هوشمندانه و جمعی رساندهاند.
کاربرد این الگوریتم در علم داده و یادگیری ماشین
در حوزهی علم داده (Data Science: دانشی برای استخراج اطلاعات و الگوهای ارزشمند از میان انبوهی از دادههای خام)، الگوریتم جنگل تصادفی به دلیل پایداری و دقت بسیار بالا، جایگاه ویژهای پیدا کرده است. یکی از بزرگترین مشکلات مدلهای هوش مصنوعی، خطای برازش بیش از حد (Overfitting: زمانی که مدل فقط دادههای تمرینی را حفظ میکند اما در مواجهه با دادههای جدید دنیای واقعی کاملا اشتباه عمل میکند) است. شبکهی وسیع درختان در جنگل تصادفی، این خطای مهلک را به حداقل میرساند.
برخی از مهمترین کاربردهای عملی این روش در دنیای امروز شامل موارد زیر است:
- پیشبینی بازارهای مالی: تحلیل حجم عظیمی از دادههای تاریخی و تکنیکال برای پیشبینی روند صعودی یا نزولی داراییهای دیجیتال.
- سیستمهای تشخیص تقلب: بررسی رفتار کاربران در صرافیها و کیف پولهای دیجیتال برای شناسایی سریع تراکنشهای مشکوک و مسدود کردن فعالیتهای غیرعادی.
- پیشنهاددهندههای هوشمند: موتورهای جستجو و پلتفرمهای فروشگاهی از این الگوریتم استفاده میکنند تا بر اساس رفتار گذشتهی کاربر، مناسبترین مقالات یا محصولات را به او پیشنهاد دهند.
- تحلیل دادههای ناقص: یکی از قدرتهای اصلی جنگل تصادفی این است که حتی اگر بخشهایی از پایگاه دادهی شما گم شده یا ناقص باشد، این مدل همچنان میتواند با دقت بالایی به کار خود ادامه دهد و نتایج قابل اعتمادی تولید کند.
تفاوت درخت تصمیم و جنگل تصادفی
برای اینکه بتوانیم قدرت واقعی الگوریتم جنگل تصادفی را درک کنیم، ابتدا باید به سراغ بلوکهای سازندهی آن برویم. همانطور که یک جنگل واقعی از صدها درخت تشکیل شده است، جنگل تصادفی در دنیای یادگیری ماشین نیز از کنار هم قرار گرفتن تعداد زیادی درخت تصمیم ساخته میشود. بنابراین، قدم اول برای یادگیری این مفهوم، شناخت دقیق درخت تصمیم و نقاط ضعف آن است.
درخت تصمیم یا Decision Tree چیست و چه محدودیتی دارد؟
درخت تصمیم (Decision Tree) یکی از سادهترین و در عین حال جذابترین روشها برای حل مسائل است. عملکرد این مدل دقیقا شبیه به بازی معروف بیست سوالی است. در این الگوریتم، دادهها از بالای درخت وارد میشوند و در هر مرحله با یک سوال یا شرط منطقی روبرو میشوند. بر اساس پاسخ (بله یا خیر)، دادهها به شاخهی بعدی میروند تا در نهایت به یک نتیجهی مشخص برسند.
هر کدام از این ایستگاههای سوالپرسیدن را در اصطلاح یک گره (Node: نقطهای که در آن یک ویژگی خاص از دادهها بررسی میشود و مسیر را به دو یا چند بخش تقسیم میکند) مینامند و به نتیجهی نهایی که در انتهای مسیر به دست میآید، برگ (Leaf: نقطهی پایان مسیر که نمایانگر تصمیم یا پیشبینی نهایی مدل است) میگویند.
اما این روش با وجود سادگی، یک محدودیت و نقطهی ضعف بسیار بزرگ دارد: خطای برازش بیش از حد (Overfitting: حالتی که مدل جزئیات و حتی نویزهای بیاهمیت دادههای آموزشی را حفظ میکند، اما در مواجهه با دادههای جدید دنیای واقعی کاملا اشتباه عمل میکند).
برای درک بهتر، دانشآموزی را تصور کنید که تمام سوالات و جوابهای کتاب ریاضی را کلمه به کلمه حفظ کرده است. او در امتحان شبیهسازیشدهی کلاس نمرهی کامل میگیرد، اما اگر در امتحان اصلی فقط یک عدد در صورت سوال تغییر کند، او کاملا گیج میشود و نمیتواند پاسخ درستی بدهد. درخت تصمیم نیز دقیقا همینگونه رفتار میکند؛ به شدت به دادههای اولیهی خود وابسته میشود و انعطافپذیری لازم برای پیشبینی شرایط جدید بازار را از دست میدهد.
چرا جنگل تصادفی عملکرد بهتری نسبت به درخت تصمیم دارد؟
الگوریتم جنگل تصادفی دقیقا برای پوشش دادن ضعفهای درخت تصمیم طراحی شده است. این الگوریتم از تکنیک یادگیری گروهی (Ensemble Learning: روشی که در آن چند مدل هوشمند با هم ترکیب میشوند تا خروجی نهایی دقیقتر و پایدارتری نسبت به یک مدل تکی ایجاد کنند) استفاده میکند. اما چرا این رویکرد گروهی عملکرد بسیار بهتری دارد؟ در ادامه به مهمترین دلایل آن اشاره میکنیم:
- کاهش وابستگی و خطای حفظ کردن دادهها: در جنگل تصادفی، ما به جای یک درخت که تمام اطلاعات را ببیند، صدها درخت داریم که هر کدام فقط بخش کوچکی از دادهها را به صورت تصادفی بررسی میکنند. این کار باعث میشود هیچ درختی نتواند کل اطلاعات را حفظ کند و در نتیجه، مشکل برازش بیش از حد حل میشود.
- مقاومت در برابر دادههای پرت: در بازارهای مالی یا اطلاعات کاربران، همیشه دادههای عجیب و غیرعادی (Outliers: دادههایی که به شکل غیرطبیعی با بقیهی اطلاعات تفاوت دارند، مثل یک خرید ناگهانی و بسیار بزرگ در صرافی) وجود دارند. یک درخت تصمیم ممکن است با دیدن این دادهی پرت کاملا مسیر پیشبینی خود را تغییر دهد، اما در جنگل تصادفی، نظر یک درخت گمراهشده در میان رای و نظر صدها درخت منطقی دیگر خنثی میشود.
- ثبات و دقت بالاتر: ترکیب نتایج مستقل چندین درخت باعث میشود که پیشبینی نهایی مدل دچار نوسانات شدید نشود و شما با اطمینان بسیار بیشتری بتوانید روی نتایج آن در پروژههای حساس حساب باز کنید.
جدول مقایسه جامع بین درخت تصمیم و جنگل تصادفی
برای اینکه تفاوت این دو مفهوم به بهترین شکل در ذهن شما تثبیت شود، خلاصهی ویژگیهای آنها را در جدول زیر مقایسه کردهایم:
|
ویژگی مورد بررسی |
درخت تصمیم (Decision Tree) |
جنگل تصادفی (Random Forest) |
|
ساختار مدل |
یک درخت واحد با قوانین پیدرپی |
مجموعهای از دهها یا صدها درخت مستقل |
|
سرعت پردازش |
بسیار سریع (نیاز به محاسبات کم) |
کندتر (به دلیل پردازش همزمان چندین مدل) |
|
خطر برازش بیش از حد |
بسیار بالا (مستعد حفظ کردن دادهها) |
بسیار پایین (به دلیل رویکرد تصادفی و گروهی) |
|
دقت پیشبینی |
متوسط (امکان خطای بالا در دادههای جدید) |
بسیار بالا (قابل اتکا برای تصمیمات حساس) |
|
درک و تفسیر خروجی |
بسیار ساده (دقیقا شبیه یک فلوچارت تصویری) |
پیچیده (مانند یک جعبهی سیاه که فقط خروجی نهایی را نشان میدهد) |
|
تاثیر دادههای پرت |
به شدت تاثیرپذیر و حساس |
بسیار مقاوم و پایدار |
الگوریتم Random Forest چگونه کار میکند؟
جادوی اصلی جنگل تصادفی در دو کلمهی کلیدی خلاصه میشود: تصادفی بودن و کار گروهی. این الگوریتم برای اینکه بتواند یک پیشبینی دقیق ارائه دهد، یک فرآیند هوشمندانه را طی میکند که در ادامه هر بخش را به زبان ساده بررسی میکنیم.
مفهوم Bootstrap Sampling و نقش آن در تولید دادههای تصادفی
اولین قدم برای ساختن یک جنگل تصادفی، آماده کردن اطلاعات برای آموزش دادن به درختها است. در این مرحله الگوریتم از روشی به نام Bootstrap Sampling (نمونهبرداری با جایگذاری: تکنیکی که در آن از پایگاه دادهی اصلی، چندین مجموعهی کوچکتر و تصادفی ساخته میشود) استفاده میکند.
برای درک این موضوع، فرض کنید یک کتابچهی ۱۰۰ صفحهای از اطلاعات صرافیهای ارز دیجیتال دارید و میخواهید آن را به ۱۰ تحلیلگر (همان درختها) بدهید تا مطالعه کنند. به جای اینکه کل ۱۰۰ صفحه را به همهی آنها بدهید، به هر تحلیلگر ۶۰ صفحهی تصادفی میدهید. در این روش ممکن است یک صفحهی خاص به چند نفر داده شود و یک صفحهی دیگر اصلا به دست کسی نرسد.
این کار باعث میشود که هر درخت، بر اساس یک مجموعهی متفاوت و منحصربهفرد از دادهها آموزش ببیند. در نتیجه، ما در جنگل خود درختهایی داریم که تخصصها و دیدگاههای متفاوتی دارند و هیچکدام کپی دقیقی از دیگری نیستند. این تنوع، کلید اصلی موفقیت الگوریتم است.
انتخاب تصادفی ویژگیها یا Feature Randomness چیست؟
علاوه بر دادههای تصادفی، جنگل تصادفی یک ترفند هوشمندانهی دیگر هم دارد که به آن Feature Randomness (انتخاب تصادفی ویژگیها: حالتی که مدل در هر مرحله از تصمیمگیری، فقط به بخش کوچکی از متغیرها یا اطلاعات نگاه میکند) میگویند.
تصور کنید میخواهید آیندهی قیمت یک توکن جدید را پیشبینی کنید. شما متغیرهای مختلفی مثل حجم معاملات، تیم توسعهدهنده، اخبار بازار و وضعیت شبکهی بلاکچین را در اختیار دارید. در یک درخت تصمیم معمولی، مدل همیشه به قویترین ویژگی (مثلا اخبار بازار) نگاه میکند و بقیهی موارد را نادیده میگیرد. این موضوع باعث میشود تصمیمات یکطرفه و متعصبانه باشند.
اما در جنگل تصادفی، الگوریتم در هر مرحله، دسترسی درخت را به همهی متغیرها میبندد و فقط چند ویژگی تصادفی (مثلا فقط حجم معاملات و وضعیت شبکه) را در اختیارش میگذارد. این محدودیت عمدی باعث میشود که درختها مجبور شوند الگوهای پنهان در سایر اطلاعات را هم یاد بگیرند و قدرت پیشبینی مدل به یک عامل خاص محدود نشود.
نحوه تصمیمگیری: رای گیری در مسائل طبقهبندی و میانگینگیری در رگرسیون
پس از اینکه تمام درختهای جنگل ساخته شدند و هر کدام به صورت مستقل آموزش دیدند، نوبت به مرحلهی نهایی یعنی نتیجهگیری میرسد. وقتی یک دادهی جدید (مثلا یک تراکنش مشکوک) وارد سیستم میشود، از تمام درختها عبور میکند و هر درخت نظر خودش را میدهد. اما سیستم چگونه این نظرات متفاوت را جمعبندی میکند؟ پاسخ به نوع مسئلهی ما بستگی دارد:
- در مسائل طبقهبندی (Classification): وقتی هدف ما دستهبندی کردن اطلاعات باشد، الگوریتم از روش رایگیری اکثریت استفاده میکند. فرض کنید میخواهیم تشخیص دهیم یک آدرس کیف پول، کلاهبرداری است یا امن. اگر در جنگل ما ۱۰۰ درخت وجود داشته باشد و ۷۵ درخت رای به کلاهبرداری بودن آدرس بدهند، تصمیم نهایی الگوریتم، کلاهبرداری بودن آن کیف پول خواهد بود.
- در مسائل رگرسیون (Regression): زمانی که هدف ما پیشبینی یک عدد خاص و پیوسته است، رایگیری معنایی ندارد و مدل از روش میانگینگیری استفاده میکند. برای مثال، اگر بخواهیم قیمت اتریوم را پیشبینی کنیم، ممکن است یک درخت عدد ۳۱۰۰ دلار، درخت دیگر ۳۰۵۰ دلار و دیگری ۳۱۵۰ دلار را پیشبینی کند. الگوریتم در اینجا تمام اعداد پیشبینیشده توسط درختان را با هم جمع کرده و میانگین آنها را به عنوان قیمت نهایی و خروجی سیستم به ما اعلام میکند.
هایپرپارامترهای مهم در الگوریتم جنگل تصادفی
در دنیای یادگیری ماشین، برای اینکه یک مدل به بهترین شکل کار کند، باید قبل از شروع به کار، تنظیمات خاصی را برای آن مشخص کنیم. به این تنظیمات اولیه، هایپرپارامتر (Hyperparameter: متغیرها و تنظیماتی که توسط برنامهنویس قبل از شروع فرآیند آموزش مدل تعیین میشوند تا رفتار و عملکرد الگوریتم را کنترل کنند) میگویند.
برای درک بهتر، یک دستگاه اسپرسوساز را تصور کنید. قبل از اینکه دستگاه شروع به عصارهگیری کند، شما باید میزان دمای آب، درجهی آسیاب قهوه و مقدار فشار آب را تنظیم کنید. این تنظیمات دقیقا همان هایپرپارامترها هستند که اگر به درستی انتخاب نشوند، قهوهی نهایی کیفیت لازم را نخواهد داشت. الگوریتم جنگل تصادفی نیز دارای تنظیمات مهمی است که در ادامه به سه مورد از کلیدیترین آنها میپردازیم.
تاثیر تعداد درختان در دقت مدل
اولین و شاید آشناترین تنظیمی که با آن روبرو میشویم، تعیین اندازهی جنگل یا همان تعداد درختان است. این پارامتر مشخص میکند که مدل ما از چند درخت تصمیم مستقل برای رسیدن به نتیجهی نهایی استفاده کند.
- افزایش دقت: به طور کلی، هرچه تعداد درختان در جنگل شما بیشتر باشد، پیشبینی نهایی مدل دقیقتر و پایدارتر خواهد بود؛ زیرا خرد جمعی قویتری شکل میگیرد و تصمیمات بر پایهی نظرات بیشتری گرفته میشوند.
- کاهش سرعت پردازش: در مقابل، افزایش بیرویهی تعداد درختان یک هزینهی پنهان دارد و آن کند شدن سیستم است. پردازش همزمان هزاران درخت به قدرت محاسباتی و زمان زیادی نیاز دارد.
بنابراین، هنر یک تحلیلگر داده در این است که نقطهی تعادلی را پیدا کند که در آن، هم دقت مدل قابل قبول باشد و هم سرعت پاسخگویی در حد معقولی برای کاربردهای واقعی حفظ شود.
کنترل عمق درخت برای جلوگیری از پیچیدگی و خطای برازش بیش از حد
تنظیم مهم بعدی، تعیین حداکثر عمق درخت (Max Depth: تعداد مراحلی که یک درخت میتواند به پرسیدن سوالات ادامه دهد و شاخههای جدید بسازد) است.
اگر شما هیچ محدودیتی برای عمق درخت در نظر نگیرید، درخت تا جایی رشد میکند که برای هر دادهی جزئی، یک قانون اختصاصی بسازد. این موضوع باعث میشود مدل به شدت پیچیده شود و خطای حفظ کردن طوطیوار اطلاعات رخ دهد.
برای مثال، اگر در حال تحلیل رفتار خریداران ارزهای دیجیتال هستید، پرسیدن سوالات کلی مانند وضعیت درآمد یا سن افراد برای رسیدن به یک الگو مفید است. اما اگر درخت شما آنقدر عمیق شود که سوالاتی مثل رنگ مورد علاقهی خریدار را هم در تصمیمگیری نهایی دخیل کند، قطعا در پیشبینی شرایط جدید دچار اشتباهات فاحشی میشود. با محدود کردن عمق درخت، به مدل میگوییم که بیش از حد روی جزئیات بیاهمیت تمرکز نکند و تصویر کلی را ببیند.
تنظیم حداقل نمونهها برای تقسیم گرهها
سومین هایپرپارامتر کلیدی، حداقل نمونهها برای تقسیم (Min Samples Split: کمترین تعداد دادهای که یک ایستگاه تصمیمگیری نیاز دارد تا مجاز باشد به شاخههای کوچکتر تقسیم شود) است.
در هر مرحله، الگوریتم باید تصمیم بگیرد که آیا نیاز است سوال جدیدی بپرسد و شاخه را به دو قسمت تقسیم کند یا خیر. اگر این پارامتر را به عنوان مثال روی عدد ۱۰ تنظیم کنیم، به این معنی است که اگر در یک شاخه کمتر از ۱۰ داده باقی مانده باشد، مدل دیگر حق ندارد آن را به شاخههای کوچکتر تقسیم کند و همانجا مسیر به پایان میرسد.
مزیت اصلی این کار جلوگیری از ایجاد قوانین بسیار خاص برای موارد استثنایی است. به عنوان مثال، در سیستم تشخیص تقلب صرافیها، ما نمیخواهیم مدل برای یک تراکنش بسیار عجیب که فقط یک بار در تاریخ رخ داده، یک قانون دائمی و جدید بسازد. با تنظیم درست این پارامتر، مدل یاد میگیرد که فقط الگوهای کلی و معنادار جامعهی آماری را در نظر بگیرد.
مزایا و معایب الگوریتم Random Forest
در دنیای تکنولوژی و هوش مصنوعی، هیچ ابزاری کامل و بینقص نیست. الگوریتم جنگل تصادفی نیز با وجود تمام قدرت و دقتی که دارد، مانند هر روش دیگری دارای نقاط قوت و ضعف خاص خود است. برای اینکه بتوانیم در پروژههای تحلیلی خود، چه در دنیای رمزارز و چه در بازارهای مالی سنتی، بهترین تصمیم را بگیریم، باید هر دو روی سکهی این الگوریتم را به خوبی بشناسیم.
نقاط قوت و دلایل محبوبیت رندوم فارست در بین توسعهدهندگان
این الگوریتم در میان دانشمندان داده و تحلیلگران مالی طرفداران بسیار زیادی دارد. دلیل این محبوبیت، مجموعهای از ویژگیهای قدرتمند است که کار با دادههای پیچیده را بسیار سادهتر میکند:
- دقت و پایداری بالا: به دلیل استفاده از خرد جمعی درختان، این مدل به شدت در برابر دادههای پرت یا اشتباه مقاوم است و خروجیهای بسیار قابل اعتمادی ارائه میدهد.
- مدیریت دادههای گمشده: در بسیاری از پروژههای واقعی، ممکن است بخشی از اطلاعات یک کاربر یا یک روز معاملاتی در پایگاه داده ثبت نشده باشد. این الگوریتم توانایی بالایی در تخمین زدن این دادههای ناقص (Missing Values: اطلاعاتی که در مجموعهی دادهی ما خالی هستند یا ثبت نشدهاند) دارد، بدون اینکه کل سیستم از کار بیفتد.
- کاربرد دوگانه: همانطور که پیشتر اشاره کردیم، شما میتوانید از این مدل هم برای دستهبندی اطلاعات و هم برای پیشبینی یک عدد خاص استفاده کنید که انعطافپذیری بالایی به برنامهنویس میدهد.
- سنجش اهمیت ویژگیها: این مدل میتواند به شما بگوید کدام اطلاعات بیشترین تاثیر را در نتیجهی نهایی داشتهاند. برای مثال، اگر در حال تحلیل وضعیت یک توکن هستید، سیستم به روشنی مشخص میکند که آیا حجم معاملات اهمیت بیشتری داشته است یا تعداد کاربران فعال در شبکهی آن توکن.
چالشها، پیچیدگیها و محدودیتهای سرعت در این الگوریتم
در کنار تمام این مزایای فوقالعاده، استفاده از جنگل تصادفی چالشهایی هم به همراه دارد که در پروژههای حساس باید به آنها توجه ویژهای داشته باشیم:
- کندی در پردازش و پیشبینی: بزرگترین نقطهی ضعف این مدل، سرعت پایین آن است. از آنجایی که سیستم باید نظر دهها یا صدها درخت را بررسی و محاسبه کند، برای کارهایی که نیاز به تصمیمگیری در لحظه (Real-time: پردازشی که باید در کسری از ثانیه و بدون تاخیر انجام شود، مانند رباتهای معاملهگر با سرعت بسیار بالا) دارند، انتخاب چندان مناسبی نیست.
- مصرف بالای منابع سختافزاری: آموزش دادن و پردازش این حجم از درختان مستقل، به حافظه و قدرت پردازشی زیادی نیاز دارد. این یعنی برای اجرای پروژههای بزرگ با این الگوریتم، به جای یک سیستم معمولی، به سرورهای قدرتمندتری نیاز خواهید داشت.
- تبدیل شدن به یک جعبهی سیاه: در یک درخت تصمیم ساده، شما به صورت بصری میبینید که سیستم چرا و چگونه به یک نتیجه رسیده است. اما وقتی صدها درخت با هم ترکیب میشوند، درک منطق نهایی بسیار سخت میشود. در واقع مدل تبدیل به یک جعبهی سیاه (Black Box: سیستمی که ورودی و خروجی آن برای ما کاملا مشخص است، اما فرآیند درونی و دلیل تصمیمگیریهای آن برای انسان قابل ردیابی و تفسیر دقیق نیست) میشود. این موضوع در تحلیلهایی که دلیل یک تصمیم به اندازهی خود تصمیم مهم است، یک چالش اساسی محسوب میشود.
کاربردهای عملی الگوریتم جنگل تصادفی در صنایع مختلف
الگوریتم جنگل تصادفی فقط یک مفهوم تئوری در کتابهای دانشگاهی نیست؛ بلکه یک ابزار بسیار کاربردی است که همین الان در پشت صحنهی بسیاری از برنامهها و سایتهایی که روزانه استفاده میکنیم، در حال کار است. این مدل به دلیل دقت بالا و توانایی پردازش حجم عظیمی از اطلاعات متنوع، در صنایع گوناگونی جای خود را باز کرده است. در ادامه به سه مورد از مهمترین کاربردهای آن میپردازیم.
پیشبینی قیمت ارزهای دیجیتال و تحلیل نوسانات بازارهای مالی
در دنیای پرهیجان بازارهای مالی، به ویژه حوزهی رمزارز، پیشبینی درست آینده میتواند تفاوت بین یک سرمایهگذاری موفق و یک ضرر سنگین باشد. تحلیلگران و توسعهدهندگان از جنگل تصادفی برای بررسی نوسانات بازار (Market Volatility: تغییرات سریع و غیرقابل پیشبینی قیمتها در یک دورهی زمانی کوتاه) استفاده میکنند.
این الگوریتم میتواند به صورت همزمان فاکتورهای مختلفی را برای پیشبینی روندها بررسی کند:
- تحلیل دادههای تاریخی: بررسی قیمتهای گذشته، حجم معاملات و الگوهای خرید و فروش در روزهای مختلف.
- تحلیل احساسات: (Sentiment Analysis: بررسی نظرات و رفتار کاربران در شبکههای اجتماعی برای درک جهتگیری کلی بازار) تا مشخص شود آیا در حال حاضر ترس بر معاملهگران حاکم است یا طمع.
- تشخیص تقلب: شناسایی رفتارهای غیرعادی و تراکنشهای مشکوک در صرافیها برای جلوگیری از کلاهبرداری و افزایش امنیت کاربران.
با کنار هم قرار دادن تمام این متغیرها، درختهای تصمیم در این جنگل میتوانند با دقت بالایی به کاربران بازار ارز دیجیتال کمک کنند تا تصمیمات منطقیتری بگیرند و اسیر هیجانات لحظهای بازار نشوند.
کاربرد در پزشکی، تشخیص بیماریها و تحلیل دادههای سلامت
پایداری و دقت بالای جنگل تصادفی باعث شده تا این الگوریتم به یک دستیار هوشمند و قابل اعتماد برای پزشکان تبدیل شود. در علم پزشکی، تشخیص زودهنگام و دقیق یک بیماری میتواند جان انسانها را نجات دهد و از خطرات احتمالی جلوگیری کند.
سیستمهای هوش مصنوعی با استفاده از این مدل، سوابق پزشکی (Medical Records: پروندهی سلامت بیمار شامل تاریخچهی بیماریها، نتایج آزمایشها، عکسبرداریها و داروهای مصرفی) هزاران بیمار را در چند ثانیه بررسی و مقایسه میکنند. به عنوان مثال، با وارد کردن اطلاعاتی مانند سن، فشار خون، سطح کلسترول و سابقهی خانوادگی به سیستم، درختان تصادفی با بررسی مستقل هر بخش از دادهها و در نهایت رایگیری، مشخص میکنند که آیا بیمار در معرض خطر ابتلا به یک بیماری خاص قرار دارد یا خیر. این خرد جمعی به کادر درمان کمک میکند تا با سرعت و اطمینان بیشتری برنامهی درمانی مناسب را آغاز کنند.
استفاده در سیستمهای پیشنهاددهنده و تجارت الکترونیک
حتما برای شما هم پیش آمده است که وقتی در یک فروشگاه آنلاین به دنبال یک محصول میگردید یا فیلمی را تماشا میکنید، پلتفرم دقیقا گزینههای مشابه و مورد علاقهی شما را پیشنهاد میدهد. این قابلیت جذاب، نتیجهی کار سیستم پیشنهاددهنده (Recommendation System: الگوریتمی که بر اساس رفتار گذشتهی کاربر، محصولات یا محتوای جدید و مرتبطی را به او معرفی میکند) است که در هستهی بسیاری از آنها از جنگل تصادفی استفاده میشود.
پلتفرمهای فروشگاهی بزرگ با پردازش اطلاعات زیر، این الگوریتم را تغذیه میکنند:
- دستهبندیها و محصولاتی که کاربر قبلا جستجو یا بازدید کرده است.
- مدت زمانی که روی یک صفحهی خاص توقف کرده است.
- تاریخچهی خریدهای قبلی کاربر و مقایسهی آن با افراد دارای سلیقهی مشابه.
الگوریتم با بررسی همزمان تمام این موارد، محصولاتی را به کاربر نمایش میدهد که بیشترین احتمال خرید را دارند. این کار نه تنها تجربهی کاربری بهتری برای مخاطب رقم میزند، بلکه باعث افزایش چشمگیر نرخ تبدیل (Conversion Rate: درصدی از بازدیدکنندگان یک سایت که در نهایت یک خرید انجام میدهند یا به مشتری تبدیل میشوند) برای صاحبان کسبوکار میشود.
مقایسه جنگل تصادفی با سایر الگوریتمهای یادگیری ماشین
در دنیای هوش مصنوعی و تحلیل دادهها، هیچ ابزاری به تنهایی نمیتواند تمام مشکلات را حل کند. درست همانطور که یک معاملهگر حرفهای در بازار رمزارز فقط به یک اندیکاتور تکیه نمیکند و از ابزارهای مختلفی برای تحلیل روند بازار کمک میگیرد، در یادگیری ماشین نیز الگوریتمهای متفاوتی وجود دارند که هر کدام برای شرایط خاصی طراحی شدهاند. برای اینکه درک بهتری از جایگاه جنگل تصادفی داشته باشیم، بسیار مهم است که آن را با رقبای قدرتمندش در دنیای داده مقایسه کنیم.
جنگل تصادفی در برابر XGBoost: کدام یک انتخاب بهتری است؟
الگوریتم ایکس جی بوست (XGBoost: یک الگوریتم یادگیری ماشین بسیار پیشرفته که بر اساس ساختار درختهای تصمیم کار میکند اما تمرکز اصلی آن بر اصلاح خطاهای قبلی است) یکی از بزرگترین و معروفترین رقبای جنگل تصادفی محسوب میشود. هر دوی این روشها از درختهای تصمیم به عنوان بلوکهای سازندهی خود استفاده میکنند، اما رویکرد آنها در حل مسئله کاملا متفاوت است.
برای درک تفاوت این دو، یک تیم تحلیلگر را برای پیشبینی قیمت آیندهی اتریوم تصور کنید:
در روش جنگل تصادفی، شما ۱۰۰ تحلیلگر را در اتاقهای جداگانه قرار میدهید. آنها همزمان و کاملا مستقل از هم وضعیت بازار را بررسی میکنند و در نهایت میانگین نظرات آنها تبدیل به خروجی سیستم میشود. این روش بسیار پایدار است و معمولا اشتباهات فاحشی مرتکب نمیشود.
اما در روش XGBoost، تحلیلگر اول بازار را پیشبینی میکند و نتیجه را روی میز میگذارد. سپس تحلیلگر دوم میآید و به جای اینکه تحلیل را از صفر شروع کند، فقط روی اشتباهات و نقاط ضعف نفر اول تمرکز میکند تا آنها را برطرف کند. نفر سوم روی اشتباهات نفر دوم کار میکند و این زنجیره ادامه مییابد.
تفاوتهای کلیدی بین این دو الگوریتم شامل موارد زیر است:
- دقت در برابر پایداری: الگوریتم XGBoost معمولا دقت بالاتری دارد و در حل مسائل بسیار پیچیده بهتر عمل میکند، اما به شدت مستعد حفظ کردن دادهها است. در مقابل، جنگل تصادفی پایداری بیشتری دارد و در مواجهه با دادههای جدید، کمتر دچار اشتباه میشود.
- سهولت در استفاده: راهاندازی و تنظیم کردن جنگل تصادفی بسیار سادهتر است و حتی با تنظیمات پیشفرض سیستم هم خروجی قابل قبولی به شما میدهد. اما XGBoost مانند یک ماشین مسابقهای است که نیاز به تنظیمات دقیق، مهارت بالا و زمان زیادی دارد تا به درستی کار کند.
- تصمیمگیری نهایی: اگر در یک پروژهی مالی به دنبال یک مدل سریع، پایدار و بدون دردسر هستید، جنگل تصادفی انتخاب بهتری است. اما اگر زمان کافی دارید، به یک سیستم قدرتمند دسترسی دارید و میخواهید بالاترین میزان دقت را از دادههای خود استخراج کنید، به سراغ XGBoost بروید.
مقایسه با سایر روشهای یادگیری گروهی یا Ensemble Learning
همانطور که در بخشهای قبلی اشاره کردیم، جنگل تصادفی زیرمجموعهی روشهای یادگیری گروهی (Ensemble Learning: تکنیکی که در آن چندین مدل هوش مصنوعی با هم ترکیب میشوند تا نتیجهی نهایی بسیار بهتر و دقیقتر از عملکرد یک مدل تکی باشد) است. اما در این خانوادهی بزرگ، روشهای دیگری هم وجود دارند که شناخت آنها به درک بهتر شما از مکانیزم این سیستمها کمک میکند.
روشهای یادگیری گروهی به طور کلی به سه دستهی اصلی تقسیم میشوند:
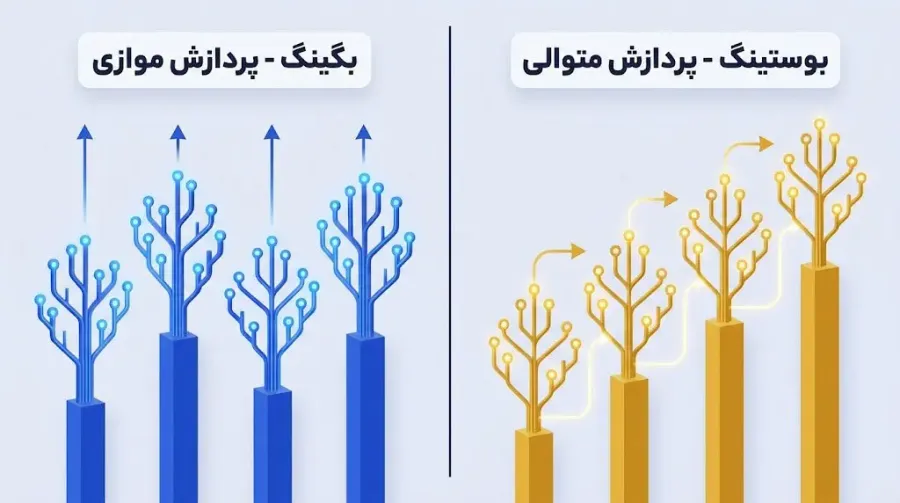
- روش بگینگ (Bagging): این دقیقا همان روشی است که جنگل تصادفی بر پایهی آن ساخته شده است. در این تکنیک، مدلها به صورت همزمان، موازی و کاملا مستقل از یکدیگر ساخته میشوند و در نهایت با رایگیری تصمیم نهایی را اعلام میکنند. هدف اصلی سیستمهای مبتنی بر بگینگ، کاهش نوسانات و جلوگیری از حفظ کردن کورکورانهی اطلاعات است. این روش مانند یک رایگیری دموکراتیک و شفاف عمل میکند.
- روش بوستینگ (Boosting): الگوریتمهایی مانند XGBoost یا AdaBoost در این دسته قرار میگیرند. در این رویکرد، مدلها به جای کار همزمان، به صورت متوالی و زنجیرهای ساخته میشوند تا هر مدل جدید، خطای مدل قبلی را جبران کند. هدف بوستینگ، کاهش دادن خطای پیشبینی و افزایش حداکثری دقت است. این رویکرد شبیه به یک سیستم استاد و شاگردی است که هر نسل از شاگردان، ضعفهای نسل قبلی را برطرف میکنند.
- روش استکینگ (Stacking): در این روش بسیار پیشرفته، ما خودمان را به استفاده از درختهای تصمیم محدود نمیکنیم. در استکینگ، مدلهای کاملا متفاوتی (مثلا ترکیب یک شبکهی عصبی، یک درخت تصمیم و یک الگوریتم خطی ساده) با هم ادغام میشوند. سپس یک هوش مصنوعی دیگر به عنوان مدیر، بالای سر آنها قرار میگیرد تا یاد بگیرد چگونه به بهترین شکل ممکن، خروجی این مدلهای متفاوت را با هم ترکیب کند. این تکنیک دقیقا شبیه به تشکیل یک هیئت مدیره از متخصصان حوزههای مختلف برای حل یک بحران پیچیدهی مالی است.
جمعبندی مفاهیم و بهترین سناریوهای استفاده
به پایان این مسیر آموزشی رسیدیم. حالا شما به خوبی میدانید که الگوریتم جنگل تصادفی (Random Forest) چیزی فراتر از یک نام پیچیدهی علمی است؛ این الگوریتم در واقع نمایندهی قدرت کار گروهی در دنیای هوش مصنوعی است. ما یاد گرفتیم که تکیه بر یک درخت تصمیم تنها، میتواند ما را به اشتباه بیندازد، اما وقتی صدها درخت با استفاده از دادههای تصادفی با همفکری و رایگیری تصمیم میگیرند، نتیجهی نهایی بسیار دقیقتر و قابل اتکاتر خواهد بود.
برای مرور سریع، بیایید مهمترین مفاهیمی که با هم بررسی کردیم را خلاصه کنیم:
- خرد جمعی به جای تصمیم فردی: این مدل از رویکرد یادگیری گروهی استفاده میکند تا با جمعآوری نظرات مختلف، خطای پیشبینی را به حداقل برساند.
- مقاومت بالا در برابر نویزها: برخلاف بسیاری از مدلهای ساده، جنگل تصادفی فریب دادههای پرت و غیرعادی بازار را نمیخورد و پایداری خود را حفظ میکند.
- انعطافپذیری بالا: این الگوریتم هم برای مسائل دستهبندی (مانند تشخیص یک ایمیل اسپم) و هم برای مسائل رگرسیون (مانند تخمین قیمت آیندهی یک دارایی) کاربرد دارد.
بهترین سناریوها برای استفاده از جنگل تصادفی
با توجه به ویژگیهای این الگوریتم، پیادهسازی آن در برخی پروژهها نتایج شگفتانگیزی به همراه دارد. اگر در حوزهی تکنولوژی مالی و رمزارزها فعالیت میکنید یا به علم داده علاقهمند هستید، بهترین زمانها برای استفاده از این مدل عبارتند از:
- تحلیل رفتار کاربران و تشخیص تقلب: در پلتفرمهای مالی، روزانه هزاران تراکنش انجام میشود. جنگل تصادفی میتواند با بررسی همزمان الگوهای واریز، برداشت و آیپی کاربران، در زمانی کوتاه تراکنشهای غیرعادی را شناسایی کرده و امنیت شبکهی مالی را افزایش دهد.
- ساخت مدلهای پیشبینی روند بازار: اگر قصد دارید یک سیستم تحلیلی بسازید که دادههای تاریخی (Historical Data: اطلاعات مربوط به قیمت، حجم معاملات و نوسانات در گذشته) را بررسی کند، این الگوریتم به دلیل پایداری بالا، یکی از بهترین گزینهها برای استخراج الگوهای پنهان قیمتی است.
- ارزیابی پروژههای جدید و دستهبندی آنها: شما میتوانید از این مدل بخواهید تا حجم عظیمی از توکنهای جدید را بر اساس ویژگیهایی مانند تعداد کاربران فعال، حجم نقدینگی و میزان فعالیت در شبکههای اجتماعی دستهبندی کند تا پروژههای مستعد رشد را از پروژههای بیارزش جدا کنید.
- پروژههای پزشکی و سلامت: در خارج از دنیای مالی، زمانی که پای جان انسانها در میان است و به هیچ وجه نمیتوان به یک پیشبینی ضعیف اتکا کرد، پزشکان از جنگل تصادفی برای بررسی پروندهی صدها بیمار و تشخیص زودهنگام بیماریهای خاص استفاده میکنند.
در نهایت، ابزارهایی مانند الگوریتم جنگل تصادفی، مسیر شما را برای درک بهتر دادههای پیچیدهی امروز روشن میکنند. با تمرین و استفاده از کدهای آمادهای که در بخشهای قبل معرفی کردیم، میتوانید اولین قدمهای عملی خود را برای ورود به دنیای جذاب تحلیل دادهها و هوش مصنوعی بردارید.
سوالات متداول
فائزه آذری فارغالتحصیل کارشناسی ارشد زبان انگلیسی است و فعالیت حرفهای خود را با ترجمه مقالات تخصصی حوزه فناوری آغاز کرده است. تجربه کار با متون فنی و منابع انگلیسیزبان، زمینه ورود او به تولید محتوای بازارهای مالی و ارزهای دیجیتال را فراهم کرده است. تمرکز او در «کیف پول من» بر توضیح ساده، دقیق و کاربردی مفاهیم فنی بلاکچین و رمزارز است.
مشاهده پروفایل
مقالات برجسته
- فدرال رزرو نرخ بهره را افزایش داد؛ آینده بیت کوین پس از تصمیم جدید آمریکا چه میشود؟۲۵ شهریور ۱۴۰۵اخبار
- اگر فدرال رزرو هفته آینده نرخ بهره را افزایش دهد، چه اتفاقی برای بیتکوین میافتد؟۲۱ شهریور ۱۴۰۵اخبار
- پیشبینی قیمت سولانا (SOL) در سالهای ۲۰۲۶ تا ۲۰۳۰؛ چشمانداز تکنیکال و پیشبینی بلندمدت۱۹ شهریور ۱۴۰۵اخبار
- پیشبینی قیمت اتریوم (ETH) در سالهای ۲۰۲۶ تا ۲۰۳۰؛ آیا ETH به ۱۰ هزار دلار میرسد؟۱۹ شهریور ۱۴۰۵اخبار
- امنیت دارایی در کیف پول من؛ رمزارز کاربران چگونه نگهداری میشود؟۱۸ شهریور ۱۴۰۵مقالات
- اجاره حساب کاربری در صرافی ارز دیجیتال درآمد آسان یا دردسر قانونی؟۱۸ شهریور ۱۴۰۵مقالات
- رکوردشکنی یونی سواپ؛ رشد Robinhood Chain سوزاندن ۱.۱۵ میلیون دلار را رقم زد۱۵ شهریور ۱۴۰۵اخبار


